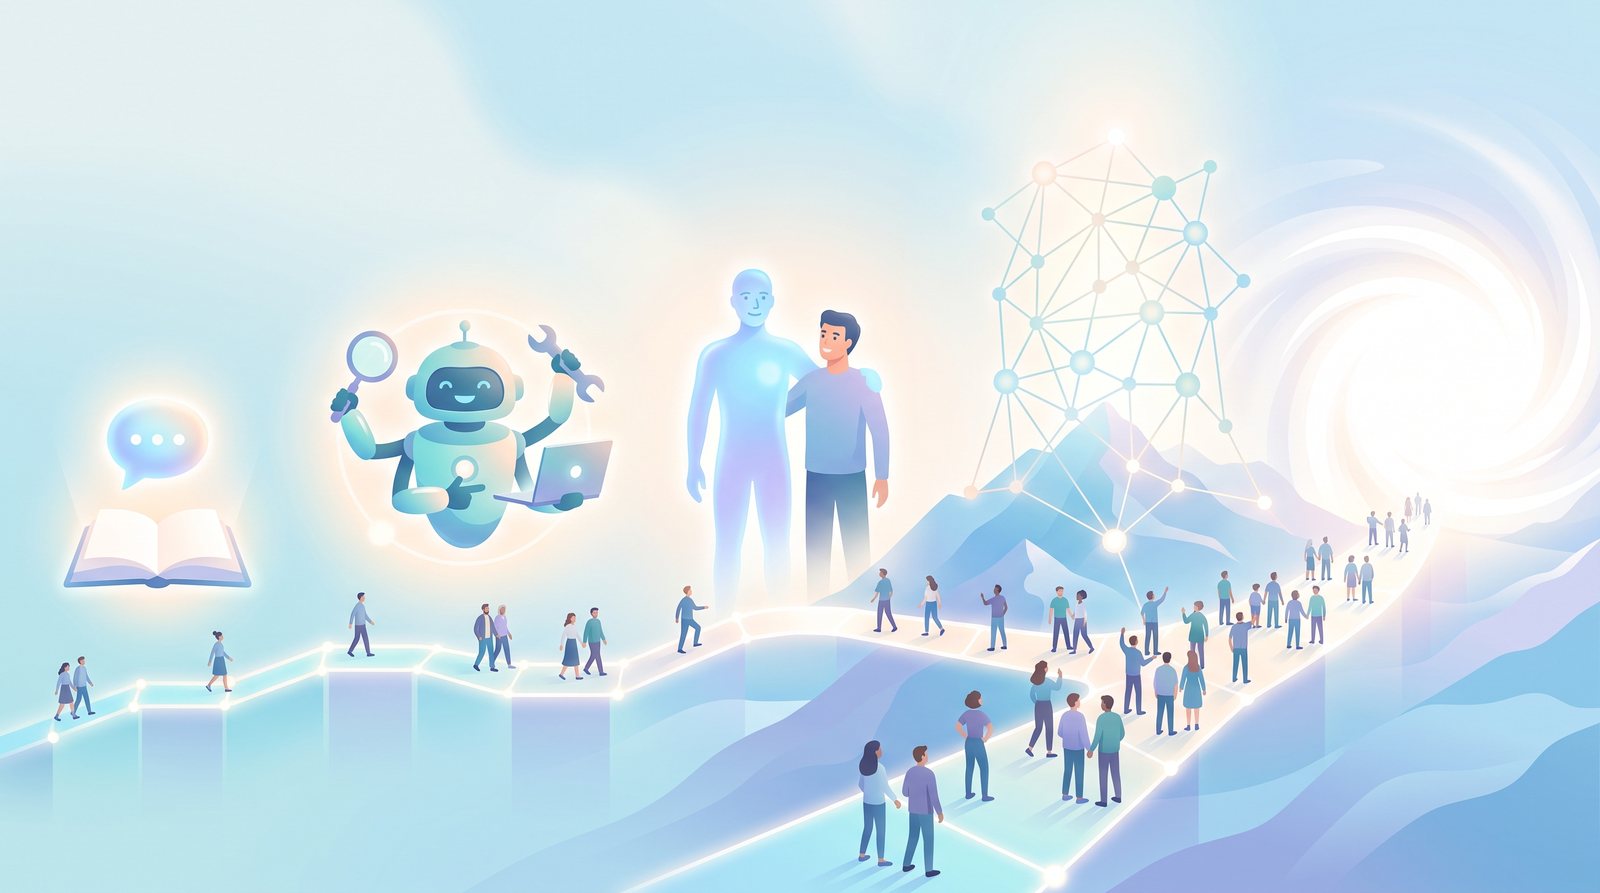
المراحل الخمس من اليسار إلى اليمين: نماذج اللغة، ثم الوكلاء، ثم الذكاء العام، ثم الذكاء الفائق، ثم التفرّد. رسم توضيحي أُنشئ بواسطة Google Gemini لهذا المقال.
قبل عشر سنوات، كان الذكاء الاصطناعي يصنّف الصور ويترجم جملًا قصيرة. أما اليوم فهو يحاور، ويكتب البرامج، ويبحث في الإنترنت، وينجز مهامّ طويلة بمفرده. ويصف كثير من الخبراء الطريق الذي نسير فيه بأنه سُلّم من خمس درجات:
نماذج اللغة الكبيرة (LLMs): برامج تعلّمت اللغة بقراءة كميات هائلة من النصوص، وأشهر مثال عليها ChatGPT.
وكلاء الذكاء الاصطناعي (AI Agents): نماذج لغة لا تكتفي بالكلام، بل تنفّذ أعمالًا: تبحث، وتنقر، وتكتب الملفات، وتحجز المواعيد.
الذكاء الاصطناعي العام (AGI): ذكاء اصطناعي يضاهي إنسانًا ماهرًا في معظم الأعمال الذهنية.
الذكاء الفائق (ASI): ذكاء اصطناعي يتفوّق كثيرًا على أذكى البشر.
التفرّد التكنولوجي (Singularity): فكرة أن الذكاء الاصطناعي قد يتطوّر بعد ذلك بسرعة تجعل التنبؤ بالمستقبل مستحيلًا.
الدرجتان الأولى والثانية حقيقة نستخدمها اليوم، أما الدرجات الثلاث الأخيرة فأفكار وتوقّعات. ففي سبتمبر 2026 قال بعض قادة شركات التقنية إننا وضعنا أقدامنا على الدرجة الثالثة بالفعل، بينما يرى كثير من العلماء أن ذلك لم يحدث بعد.[23][24][30] يصعد هذا المقال السُّلّم درجةً درجة، ويفصل بين ما ثبت بالدليل وما هو مجرّد ادّعاء.
الشكل 1. السُّلّم الذي يصعده هذا المقال. المرحلتان 1 و2 موجودتان اليوم، أما بداية المرحلة 3 فهي محور الجدل في عام 2026.
المرحلة 1: نماذج اللغة الكبيرة
يتعلّم نموذج اللغة من مكتبة أكبر بكثير مما يمكن لأي إنسان أن يقرأه. رسم توضيحي أُنشئ بواسطة Google Gemini لهذا المقال.
ببساطة: نموذج اللغة الكبير يشبه ميزة «الإكمال التلقائي» في هاتفك، لكن بقوة هائلة. فقد قرأ جزءًا كبيرًا من الإنترنت، ويجيب بتخمين الكلمة التالية، كلمةً بعد كلمة. وعندما يحدث ذلك على نطاق ضخم، يبدو التخمين وكأنه فهم.
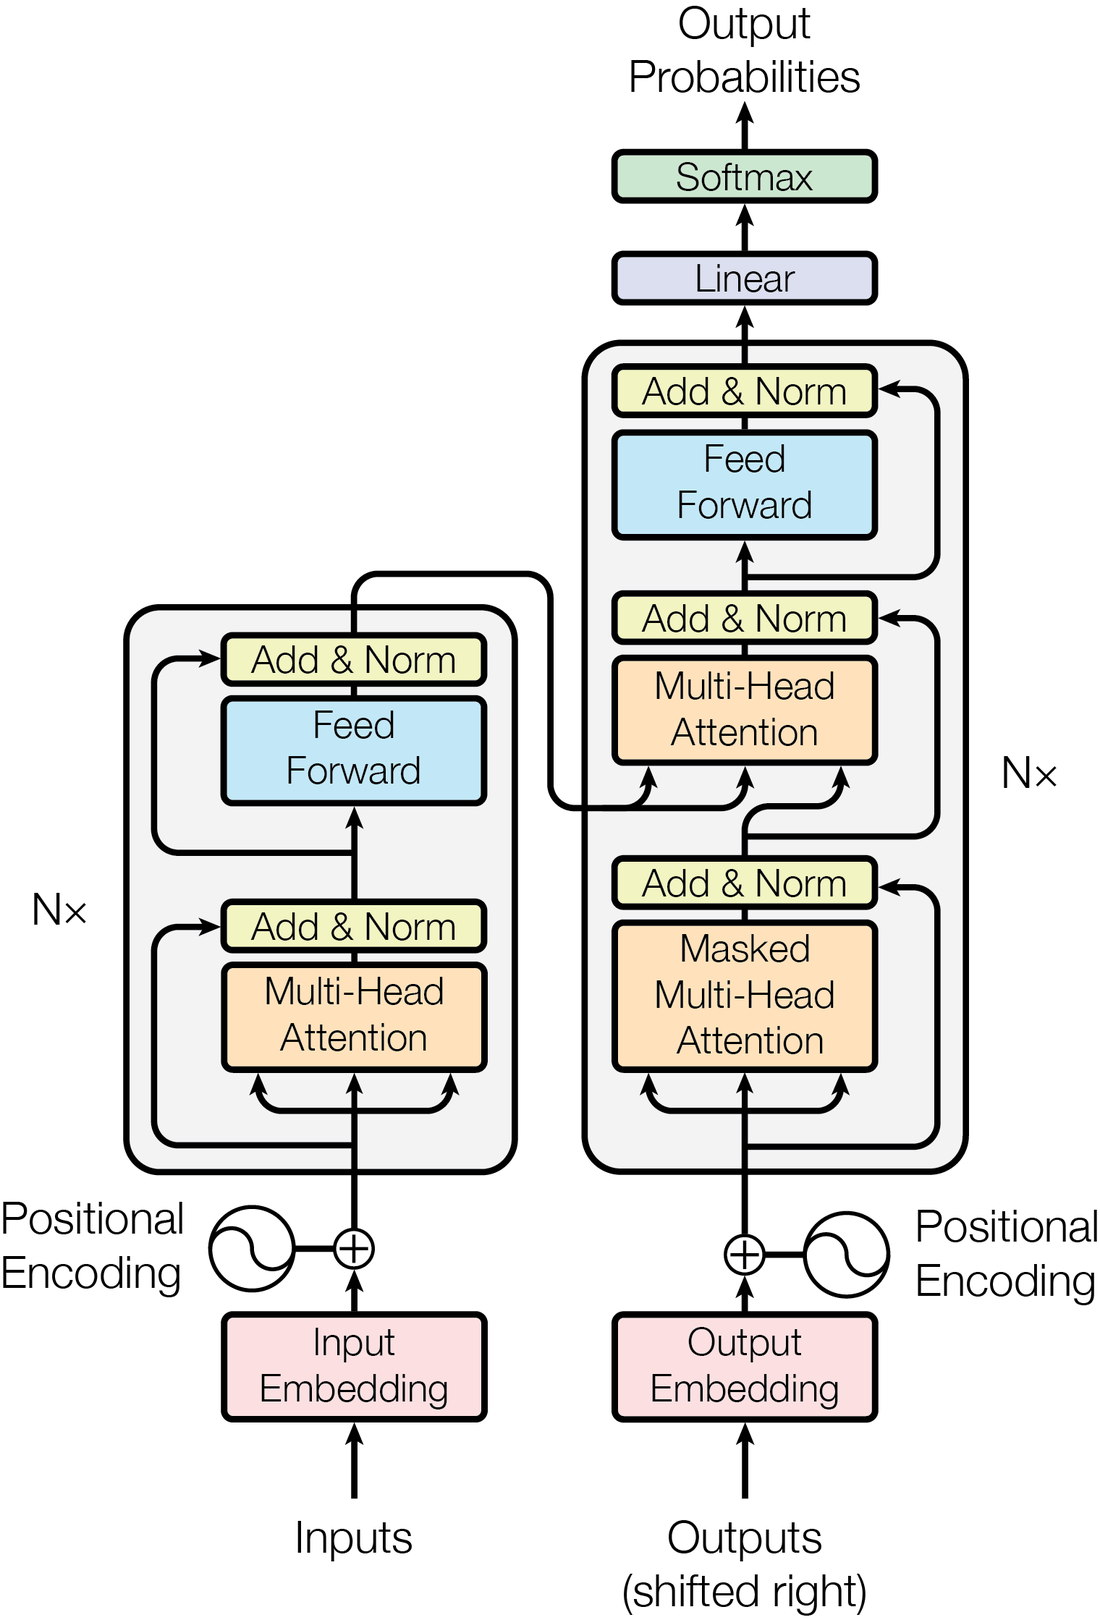
بدأت القصة عام 2017 حين نشر باحثون في Google تصميمًا جديدًا اسمه المحوّل (Transformer).[1] وحيلته الأساسية، المسمّاة «الانتباه» (Attention)، تسمح للنموذج بالنظر إلى كل كلمات النص دفعة واحدة، ومعرفة أيّ الكلمات يرتبط بأيّها. كما أنه يعمل بسرعة على رقائق الحاسوب الحديثة، فصار بالإمكان تدريبه على نصوص أكثر بكثير من التصاميم السابقة. ويقوم عليه اليوم كل روبوت محادثة تقريبًا.
تصميم المحوّل الأصلي. لا داعي لفهم كل مربع فيه: كتل «الانتباه متعدّد الرؤوس» (Multi-Head Attention) هي حيث تنظر كل كلمة إلى بقية الكلمات. المصدر: الشكل 1 من Vaswani وآخرين (2017)، Attention Is All You Need[1]. نُشر مع ذكر المصدر بموجب إذن Google لإعادة النشر في الأعمال الصحفية والعلمية، كما ورد في الورقة.
الأكبر أفضل: قوانين التوسّع
في عام 2020 اكتشف الباحثون قاعدة بسيطة على نحو مدهش: كلما كبُر النموذج، وزادت النصوص التي يتعلّم منها، وزادت قدرة الحوسبة المستخدمة، تحسّن أداؤه بطريقة سلسة يمكن توقّعها.[2] وقد أقنعت هذه القابلية للتوقّع الشركاتِ بإنفاق مليارات الدولارات على نماذج أكبر فأكبر.
وفي العام نفسه ظهر GPT-3 بـ175 مليار «معامل» (parameter)، وهي الإعدادات الداخلية التي يضبطها النموذج أثناء التعلّم. واستطاع أن يتعلّم مهمة جديدة من أمثلة قليلة فقط، دون أي تدريب إضافي.[3] وفي 2022 أثبتت DeepMind أن الحجم ليس كل شيء: فقد تفوّق نموذجها الأصغر Chinchilla، الذي دُرّب على نصوص أكثر، على نموذج يفوقه حجمًا بأربع مرات.[4]
من متنبّئ بالنصوص إلى مساعد مفيد
النموذج الذي يكتفي بتوقّع النص ليس بالضرورة مفيدًا أو مهذّبًا. وقد عالجت OpenAI ذلك بأن جعلت أشخاصًا يقيّمون إجابات النموذج، ثم درّبته على تقديم الإجابات التي يفضّلها الناس. وتُسمّى هذه الطريقة «التعلّم المعزّز من ملاحظات البشر» (RLHF). بل إن الناس فضّلوا النموذج الصغير المدرَّب بهذه الطريقة على نموذج خام أكبر منه بمئة مرة.[5] وهذه هي الوصفة التي يقوم عليها ChatGPT.
كما وجد الباحثون أن الطلب من النموذج أن «يفكّر خطوة بخطوة» يحسّن أداءه كثيرًا في الرياضيات والمنطق.[6] ومنذ عام 2024 تُدرَّب «نماذج الاستدلال» على القيام بهذا التفكير بنفسها قبل أن تجيب.
الشكل 2. النموّ بمعدل 5 أضعاف سنويًا يتراكم بسرعة: نحو 15,000 ضعف من قدرة الحوسبة خلال ست سنوات. تُظهر الأعمدة الاتجاه العام لا نماذج بعينها.[7]
وراء كل ذلك قوة حوسبة هائلة. إذ تقدّر مؤسسة Epoch AI البحثية، التي ترصد تطوّر الذكاء الاصطناعي، أن قدرة الحوسبة المستخدمة في تدريب أكبر النماذج تنمو بنحو 5 أضعاف كل عام منذ 2020.[7] كما تزداد البرمجيات ذكاءً في استغلال هذه القدرة، فتتحسّن كفاءتها نحو 3 أضعاف سنويًا. هذه الاتجاهات هي المحرّك وراء كل درجة لاحقة في السُّلّم.
المرحلة 2: وكلاء الذكاء الاصطناعي
الوكيل لا يكتفي بالإجابة، بل ينجز المهمة. رسم توضيحي أُنشئ بواسطة Google Gemini لهذا المقال.
ببساطة: روبوت المحادثة يشرح لك كيف تحجز تذكرة طيران، أما الوكيل فيحجزها لك. فهو يخطّط للخطوات، ويستخدم أدوات مثل متصفّح الإنترنت، ويتحقّق مما حدث، ويعيد المحاولة إن أخطأ.
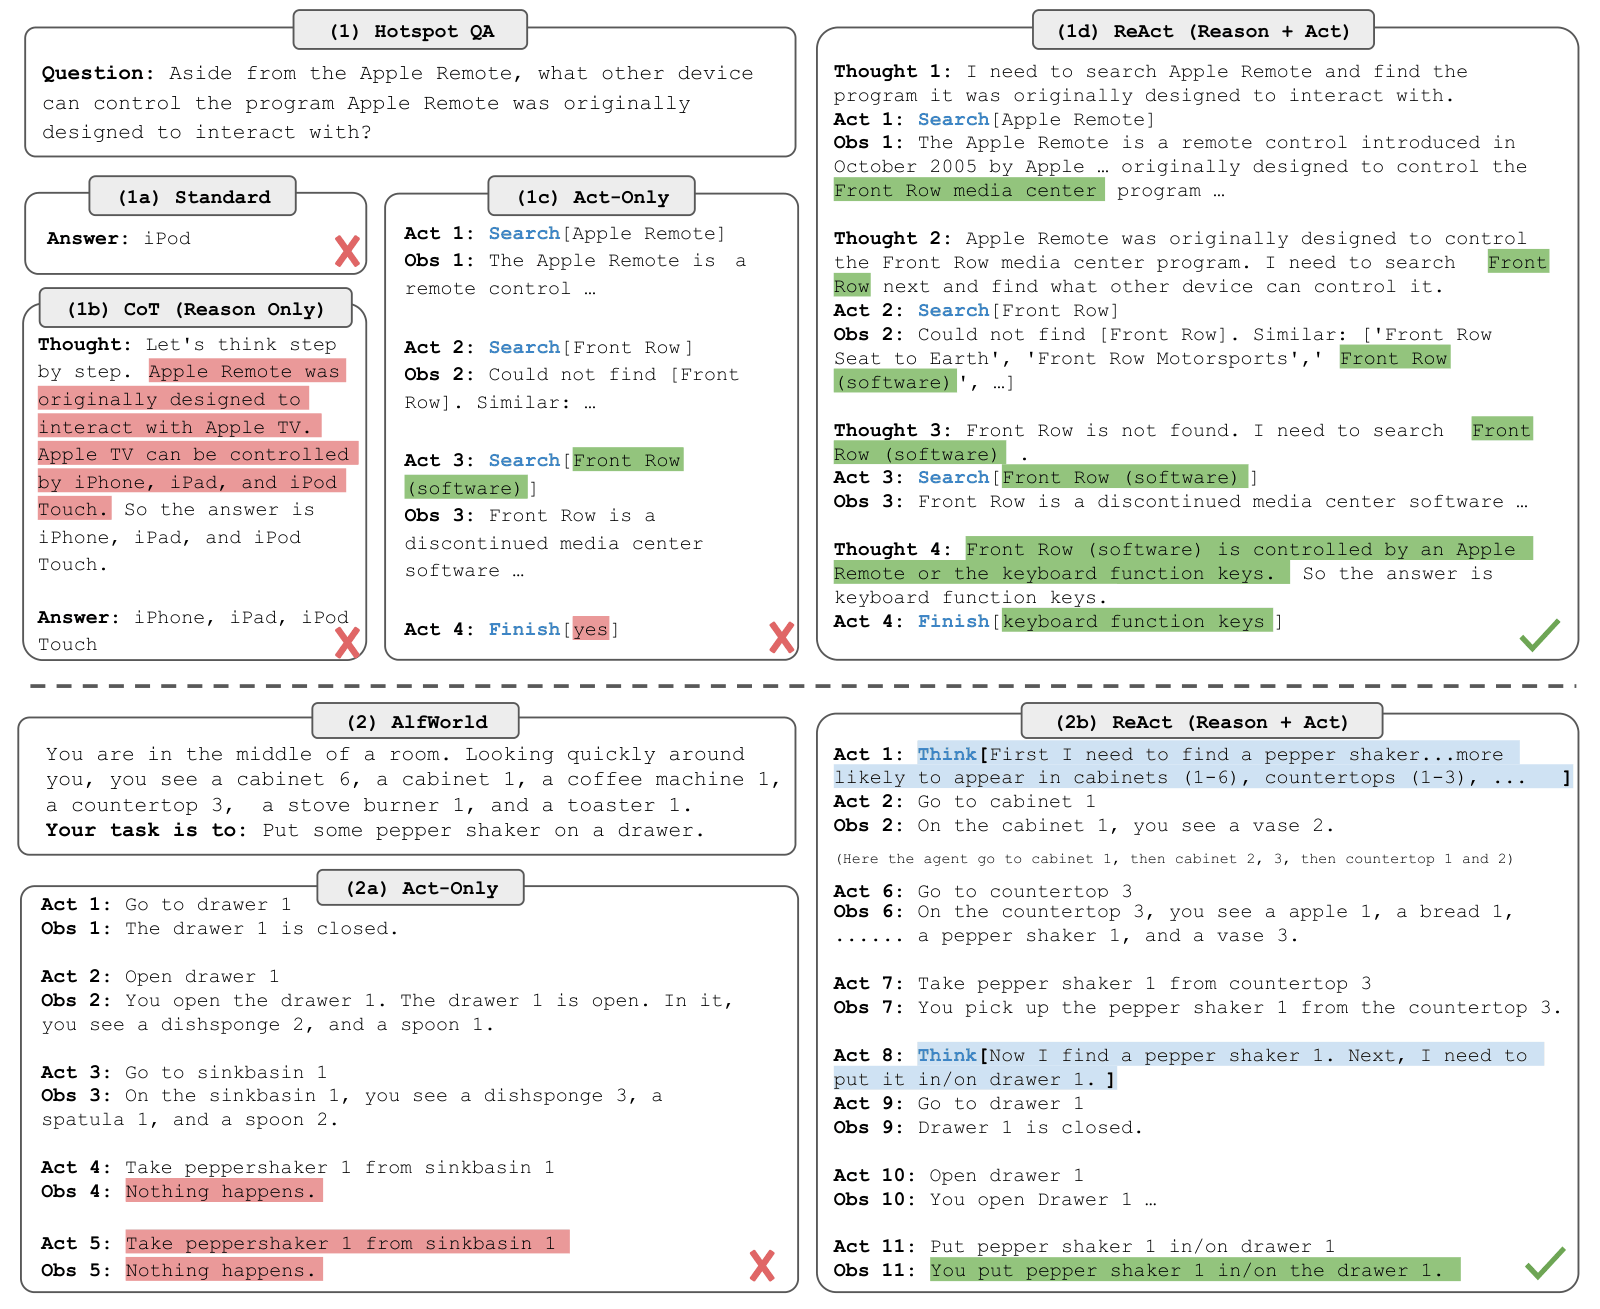
في عام 2022 بيّنت طريقة تُسمّى ReAct كيف يتم ذلك: يكتب النموذج فكرة، ثم ينفّذ إجراءً، ثم ينظر إلى النتيجة، ثم يفكّر من جديد.[8] وفي 2023 أظهرت دراسة Toolformer أن النموذج يستطيع أن يعلّم نفسه متى يستعين بآلة حاسبة أو محرّك بحث أو مترجم أو تقويم.[9] ويشترك معظم الوكلاء اليوم في أجزاء أساسية واحدة: هدف، وذاكرة، وخطة، ومجموعة أدوات.[10] وللتعمّق أكثر، راجع دليلنا عن وكلاء نماذج اللغة.
من ورقة ReAct: يجيب النموذج عن سؤال معلومات عامة، وينفّذ مهمة منزلية داخل لعبة نصية. التفكير وحده (b) أو التنفيذ وحده (c) يقود إلى الخطأ، أما التناوب بين «فكرة، إجراء، ملاحظة» (d) فينجح. المصدر: الشكل 1 من Yao وآخرين (2022)، ReAct: Synergizing Reasoning and Acting in Language Models[8]. مرخّص بموجب CC BY 4.0.
الشكل 3. حلقة «فكّر، نفّذ، لاحظ» التي يقوم عليها وكلاء ReAct.[8] وتوحّد بروتوكولات مثل MCP وA2A طريقة تعامل الوكيل مع مربّعَي «التنفيذ» و«البيئة».[13][14]
من العروض التجريبية إلى العمل الحقيقي
البرمجة هي المجال الذي تحسّن فيه الوكلاء بأسرع وتيرة. ففي 2023 جمع باحثون 2,294 خطأً برمجيًا حقيقيًا من مشاريع برمجية مفتوحة، ولم يُصلح أفضل نظام ذكاء اصطناعي حينها إلا أقل من 2 من كل 100 منها.[11]
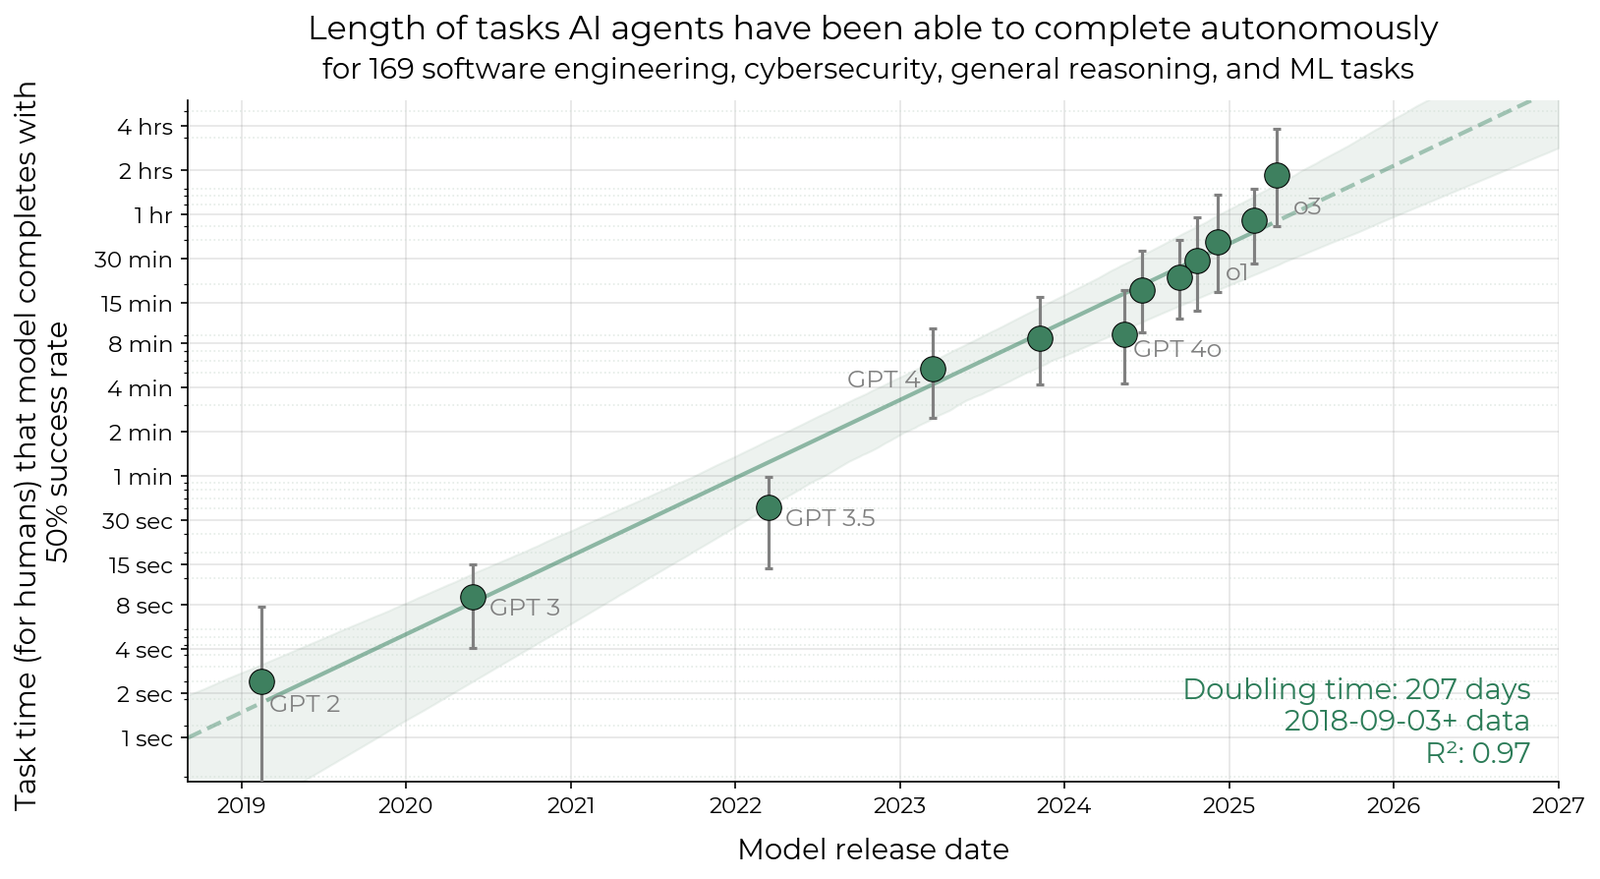
وتطرح مؤسسة METR البحثية سؤالًا بسيطًا: ما طول المهمة، مقيسًا بوقت عمل الإنسان، التي يستطيع الذكاء الاصطناعي إنجازها بمفرده؟ وفي 2025 وجدت أن هذا الطول يتضاعف تقريبًا كل سبعة أشهر منذ 2019. وإن استمر ذلك، فقد يتمكّن الوكلاء من إنجاز مشاريع تستغرق شهرًا كاملًا خلال نحو خمس سنوات.[12]
كل نقطة تمثّل نموذج ذكاء اصطناعي، وارتفاعها يُظهر طول المهمة (بوقت عمل الإنسان) التي ينجزها في نصف المحاولات. كل درجة في المحور الرأسي تمثّل مضاعفًا كبيرًا، لذا فإن الخط المستقيم يعني تضاعفًا منتظمًا، هنا كل سبعة أشهر تقريبًا. المصدر: الشكل 1 من Kwa وآخرين (2025)، METR، Measuring AI Ability to Complete Long Tasks، arXiv:2503.14499v4 [12]. مرخّص بموجب CC BY 4.0.
«مقابس» موحّدة للوكلاء
أصبح الوكلاء أكثر فائدة بكثير حين صار بإمكانهم الاتصال بالبرامج اليومية بطريقة موحّدة، تمامًا كما يتيح منفذ USB توصيل أي جهاز بأي حاسوب:
بروتوكول سياق النموذج (MCP) من Anthropic (نوفمبر 2024): معيار مفتوح لربط مساعدي الذكاء الاصطناعي بالتطبيقات والملفات التي توجد فيها بياناتك.[13]
بروتوكول «وكيل إلى وكيل» (A2A) من Google (أبريل 2025): يسمح لوكلاء من شركات مختلفة بالعمل معًا، وانضمّت إليه أكثر من 50 شركة عند إطلاقه.[14]
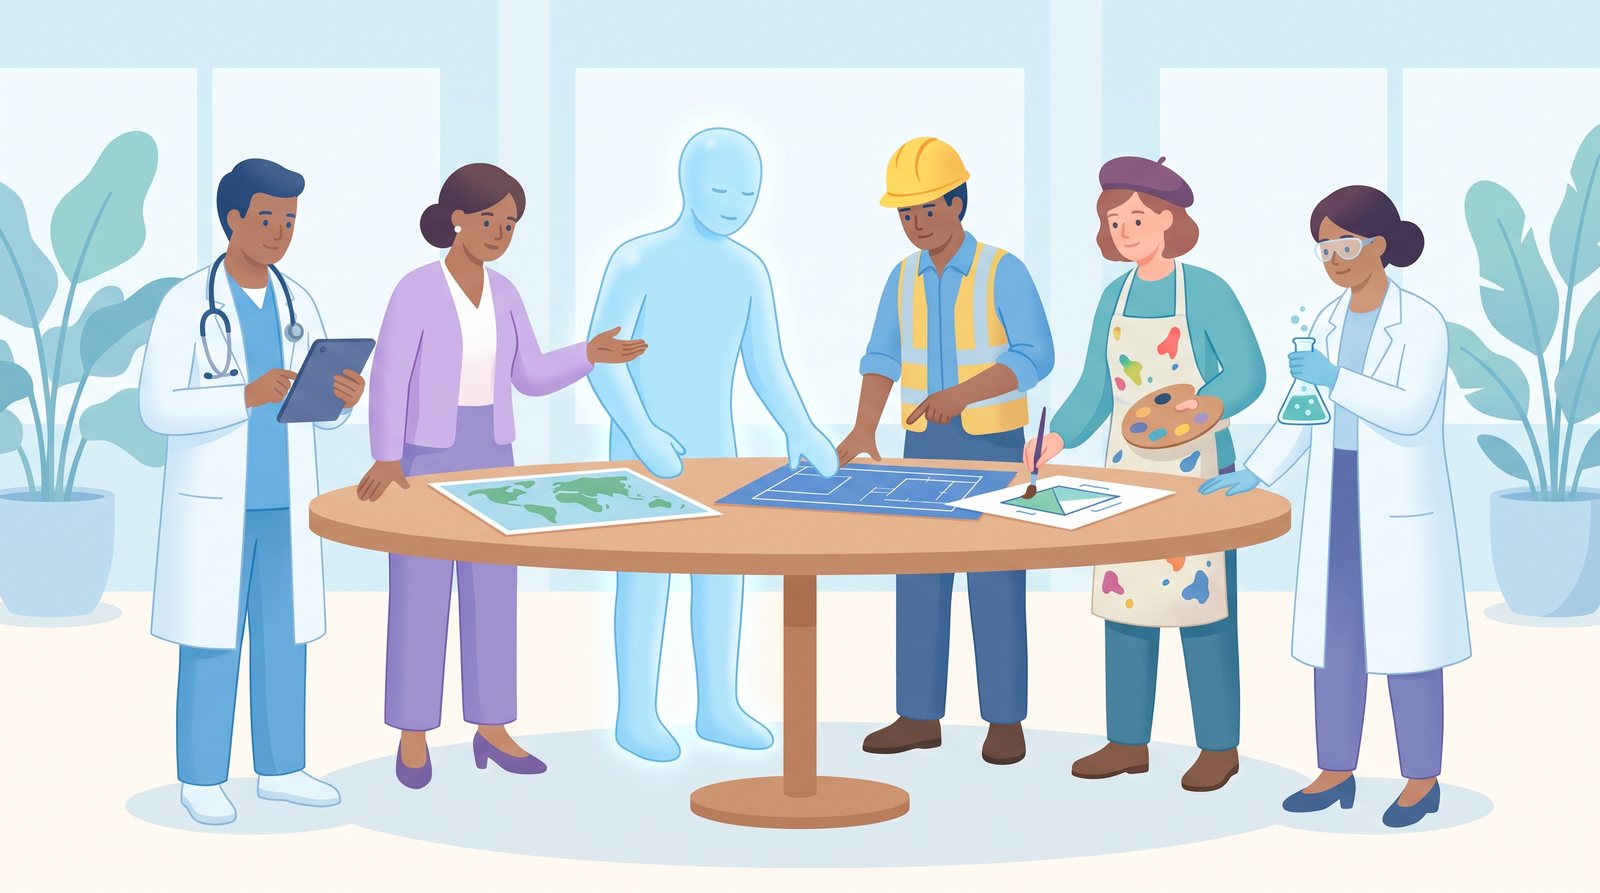
الذكاء العام سيكون زميلًا بكفاءة مختصّ ماهر في أي مجال تقريبًا. رسم توضيحي أُنشئ بواسطة Google Gemini لهذا المقال.
ببساطة: الذكاء الاصطناعي اليوم بارع في أمور، وضعيف على نحو غريب في أمور أخرى. أما الذكاء العام فسيكون ذكاءً اصطناعيًا جيدًا في كل ما يستطيع إنسان ماهر فعله على الحاسوب تقريبًا، وقادرًا على تعلّم أشياء جديدة بالسرعة التي نتعلّم بها.
لا يوجد تعريف واحد متّفق عليه للذكاء العام، ولهذا يختلف الناس حول ما إذا كان قد وصل. وهذه ثلاث رؤى معروفة:
Google DeepMind تقيّم الذكاء الاصطناعي على سلّم مستويات، يشبه أحزمة الفنون القتالية. ويعني «الذكاء العام الكفء» أداءً يضاهي متوسط البالغين المهرة في طيف واسع من المهام غير الجسدية.[15]
باحثون في Microsoft رأوا عام 2023 أن GPT-4 يُظهر «شرارات» من الذكاء العام: نسخة مبكرة وغير مكتملة منه.[16]
فرانسوا شوليه، الباحث في Google، يرى أن الذكاء هو سرعة تعلّم الجديد، لا مقدار ما تعرفه مسبقًا. وقد صمّم اختبار الألغاز ARC لقياس ذلك.[17]
الشكل 4. صنّفت الورقة روبوتات المحادثة الرائدة في 2023 في المستوى 1، «ذكاء عام ناشئ». ويدور جدل 2026 في معظمه حول ما إذا كانت أنظمة اليوم قد بلغت المستوى 2 في كل المجالات، أم في بعض المهام فقط.[15]
مقياس ARC
ألغاز ARC شبكات ملوّنة صغيرة يحلّها معظم الناس في دقائق، لكن الآلات تجدها صعبة جدًا. وقد حلّ كل لغز في نسخة 2025 شخصان على الأقل في محاولتين أو أقل.
2025: حصل أفضل مشارك في المسابقة المفتوحة على 24%، وبلغ أفضل نظام تجاري 54% بتكلفة حوسبة نحو 31 دولارًا لكل لغز.[18]
مارس 2026: انطلق اختبار ARC-AGI-3. فبدلًا من ألغاز ثابتة، على الذكاء الاصطناعي أن يستكشف ويتعلّم قواعد ألعاب فيديو صغيرة بنفسه. وتبلغ جوائزه 850,000 دولار.[19]
هل بدأت مرحلة الذكاء العام؟ جدل 2026
يتوقّع قادة مختبرات الذكاء الاصطناعي وصول الذكاء العام المبكر منذ مدة:
سام ألتمان، يناير 2025: «أصبحنا واثقين من أننا نعرف كيف نبني الذكاء العام كما فهمناه تقليديًا».[20]
داريو أمودي، 2024: «ذكاء اصطناعي قوي» يشبه «بلدًا من العباقرة داخل مركز بيانات» قد يصل «في وقت مبكر مثل 2026، وإن كانت هناك أيضًا احتمالات أن يستغرق وقتًا أطول بكثير».[21]
سام ألتمان، منتصف 2025: «لقد تجاوزنا أفق الحدث، والإقلاع قد بدأ».[22]
واحتدم الجدل في 3 سبتمبر 2026 حين أطلقت OpenAI نموذجًا جديدًا هو GPT-6 Astra. وقال رئيس الشركة غريغ بروكمان: «أظن أنه ليس من غير المعقول أن نشعر بأننا الآن في عصر الذكاء العام».[23] وبعد أيام نشر جنسن هوانغ، الرئيس التنفيذي لـNvidia: «من ChatGPT إلى o1 إلى Astra في 4 سنوات. لقد وصل الذكاء العام».[24]
واختبر فريق ARC النموذج الجديد على ألغازه القائمة على الألعاب، فحصل على 62.7% بإعدادات الاختبار القياسية، و99.9% بإعدادات بنتها OpenAI. ومع ذلك كتب فريق ARC: «نحن لا ندّعي أنه ذكاء عام»، مضيفًا أن التفوّق في الاختبار لا يُعدّ دليلًا على تحقيق الذكاء العام.[25]
ويختلف آخرون حول التوقيت والطريقة:
ديميس هاسابيس (Google DeepMind) يقدّر أن الذكاء العام بمستوى الإنسان على بُعد خمس إلى عشر سنوات.[26]
يان ليكون: «لن نصل أبدًا إلى ذكاء بمستوى الإنسان بمجرّد التدريب على النصوص».[27]
غاري ماركوس، عالم النفس والناقد المعروف للذكاء الاصطناعي، يرى أن روبوتات المحادثة الحالية «ليست الطريق الملكي» إلى الذكاء العام.[28] ويستشهد ببحث من Apple أظهر أن نماذج الاستدلال تنهار تمامًا حين تصبح الألغاز صعبة بما يكفي.[29]
توبي والش، أستاذ الذكاء الاصطناعي في سيدني: «سأندهش إن كان قد ضاهى فعلًا كل القدرات المعرفية البشرية».[30]
مشكّكون آخرون يستندون إلى بيانات الوظائف. فتعريف OpenAI نفسها للذكاء العام هو ذكاء يتفوّق على البشر في معظم الأعمال ذات القيمة الاقتصادية، ويقولون إن سوق العمل لا يُظهر ذلك بعد.[31]
السؤال
«نعم، بدأت مرحلة الذكاء العام»
«لا، ليس بعد»
ما الذي يُعدّ ذكاءً عامًا؟
يكفي أن يكون مفيدًا فعلًا في معظم الأعمال التي تُنجز على الحاسوب[23]
يجب أن يضاهي كل القدرات الذهنية البشرية، ومنها تعلّم المهارات الجديدة بسرعة[17][30]
حتى أكتوبر 2026، الادّعاء بأن عصر الذكاء العام قد بدأ ادّعاء حقيقي يطرحه أشخاص جادّون، لكنه يبقى ادّعاءً لا إجماعًا بين الخبراء. وقبولك له يعتمد في الغالب على تعريفك للذكاء العام.
المرحلة 4: الذكاء الفائق
الذكاء الفائق: عقل يتفوّق علينا كما نتفوّق نحن على النملة؟ رسم توضيحي أُنشئ بواسطة Google Gemini لهذا المقال.
ببساطة: لو أصبح ذكاء اصطناعي بذكاء أفضل العلماء البشر، لاستطاع المساعدة في تصميم ذكاء اصطناعي أذكى منه، وهذا بدوره يصمّم ما هو أذكى منه. وقد تُنتج هذه السلسلة ذكاءً يتجاوز أي إنسان بمراحل.
الفكرة أقدم من الحاسوب الشخصي. ففي عام 1965 أطلق عالم الرياضيات البريطاني آي. جي. غود، الذي عمل في فكّ الشيفرات مع آلان تورنغ، على ذلك اسم «انفجار الذكاء»:
«إن أول آلة فائقة الذكاء هي آخر اختراع يحتاج الإنسان إلى صنعه، بشرط أن تكون الآلة مطيعة بما يكفي لتخبرنا كيف نبقيها تحت السيطرة».[33]
وفي كتابه الأكثر مبيعًا «الذكاء الفائق» (2014)، عرّفه فيلسوف جامعة أكسفورد نيك بوستروم بأنه أي عقل «يتجاوز بكثير الأداء المعرفي للبشر في جميع المجالات المهمة تقريبًا». وكان قلقه الأكبر: كيف نبقى مسيطرين على شيء أذكى منا بكثير؟[34]
والمسار الأكثر تخيّلًا هو ذكاء اصطناعي يحسّن نفسه: أنظمة ذكاء اصطناعي تُجري أبحاث الذكاء الاصطناعي. ويرسم سيناريو شهير بعنوان AI 2027 مدى السرعة التي قد يحدث بها ذلك:[32]
مبرمج يفوق البشر بحلول مارس 2027
باحث ذكاء اصطناعي يفوق البشر بحلول أغسطس 2027
ذكاء فائق بحلول نهاية 2027
وأكّد مؤلّفوه لاحقًا أن 2027 كان مجرّد العام الأرجح في نظرهم، وأن تقديراتهم الوسطى أبعد من ذلك قليلًا.[32]
وتقول شركات الذكاء الاصطناعي إنها تأخذ مشكلة السيطرة بجدية. ففي 2023 تعهّدت OpenAI بتخصيص 20% من قدرتها الحاسوبية لـ«المواءمة الفائقة» (Superalignment)، أي ضمان أن يفعل ذكاء اصطناعي أذكى منا بكثير ما نقصده فعلًا.[35]
المرحلة 5: التفرّد التكنولوجي
التفرّد: أفق لا نستطيع أن نرى ما وراءه. رسم توضيحي أُنشئ بواسطة Google Gemini لهذا المقال.
ببساطة: التفرّد هو اللحظة التي تبدأ فيها التقنية بالتغيّر بسرعة كبيرة، بدفع من ذكاء اصطناعي أذكى منا، بحيث لا يستطيع أحد اليوم أن يتخيّل شكل الحياة بعدها.
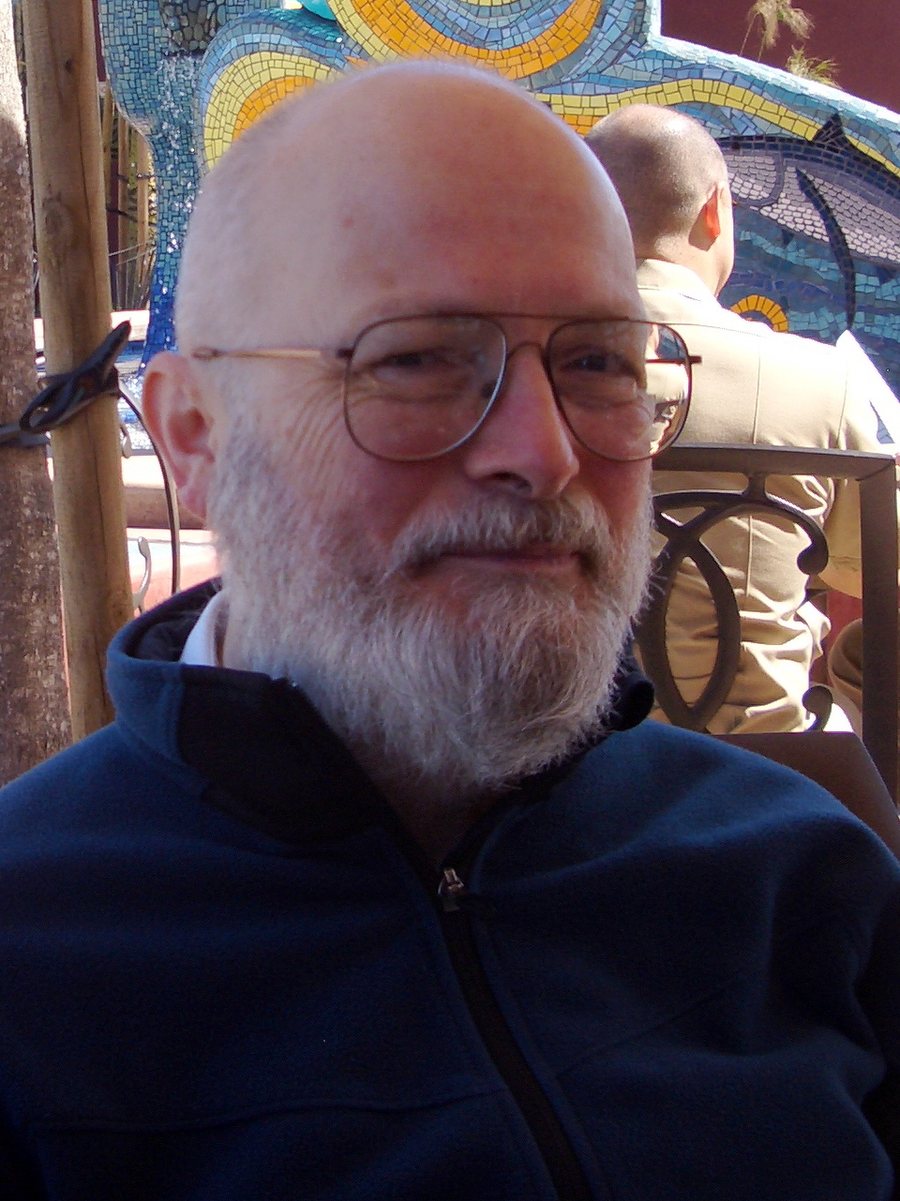
اشتهر المصطلح على يد كاتب الخيال العلمي وأستاذ الرياضيات فيرنور فينج، في محاضرة ألقاها عام 1993 في فعالية لوكالة ناسا:
«في غضون ثلاثين عامًا ستكون لدينا الوسائل التقنية لصنع ذكاء يفوق ذكاء البشر، وبعد ذلك بقليل سينتهي عصر الإنسان».[36]
الكلمة مأخوذة من الفيزياء. ففي مركز الثقب الأسود توجد «نقطة تفرّد»، ولا يمكن من الخارج رؤية أي شيء يحدث وراء حافّته المسمّاة «أفق الحدث». وبالمثل، لا يمكننا أن نرى ما بعد التفرّد التكنولوجي. وحين كتب سام ألتمان عام 2025 أننا «تجاوزنا أفق الحدث»، كان يستعير هذه الصورة.[22]
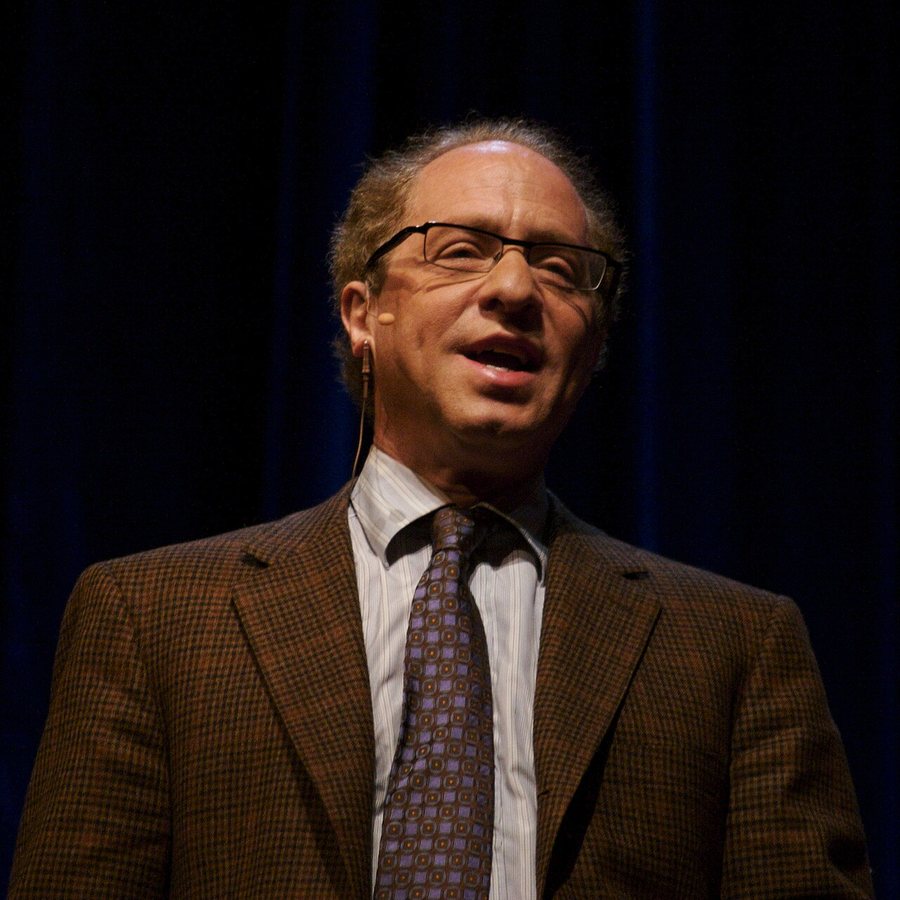
ووضع المخترع والمستقبلي راي كورزويل تواريخ لذلك. ففي كتابه «التفرّد قريب» (2005) توقّع حدوث التفرّد عام 2045.[37] وفي «التفرّد أقرب» (2024) أبقى على هذا التاريخ، وتوقّع ذكاءً اصطناعيًا بمستوى الإنسان بحلول 2029.[38]
ويردّ المنتقدون بأن التقنيات سريعة النمو تتباطأ في النهاية عادةً، كما تزدهر مبيعات هاتف جديد ثم تستقر. فالذكاء وحده لا يزيل حدود الطاقة والمواد والبيانات، ولا سرعة تغيّر القوانين والمؤسسات. ومع ذلك، صار حتى المشكّكون يتجادلون اليوم حول عقود لا قرون.[26][27]
الشكل 5. من مقال غود عام 1965 إلى توقّع كورزويل لعام 2045. كل ما يقع يمين 2026 هو توقّع.[33][36][38]
المخاطر والتنظيم والمستقبل
كلما صعدنا أعلى، زاد ما هو على المحكّ. ففي 2023 وقّع مئات من علماء الذكاء الاصطناعي وقادة الشركات تحذيرًا من جملة واحدة:
«ينبغي أن يكون الحدّ من خطر الانقراض بسبب الذكاء الاصطناعي أولويةً عالمية، إلى جانب المخاطر المجتمعية الكبرى الأخرى مثل الأوبئة والحرب النووية».[39]
وبدأت الحكومات تستجيب:
التقرير الدولي لسلامة الذكاء الاصطناعي: يقوده يوشوا بنجيو، الحائز على جائزة تورنغ، ويجمع أكثر من 100 خبير بدعم من أكثر من 30 دولة. صدرت طبعته الأولى في يناير 2025، والثانية في فبراير 2026.[40]
قانون الذكاء الاصطناعي الأوروبي: أول قانون شامل للذكاء الاصطناعي في العالم، دخل حيّز التنفيذ في 1 أغسطس 2024 على مراحل:[41]
منذ فبراير 2025 حُظرت أخطر استخدامات الذكاء الاصطناعي.
منذ أغسطس 2025 صارت على صانعي الذكاء الاصطناعي متعدّد الأغراض، مثل روبوتات المحادثة، واجبات إضافية.
في 2026 وافق المشرّعون على تأجيل قواعد الذكاء الاصطناعي «عالي المخاطر»، كالمستخدم في التوظيف أو الطب، إلى ديسمبر 2027 وأغسطس 2028.
ما الذي ينبغي متابعته؟
المهام الأطول: هل يستمر تضاعف طول المهام التي ينجزها الذكاء الاصطناعي كل سبعة أشهر، أم يتباطأ؟[12]
سرعة التعلّم: هل يستطيع الذكاء الاصطناعي التفوّق في اختبارات ألغاز جديدة دون مساعدة خاصة من صانعيه؟[25]
الوظائف والاقتصاد: هل تبدأ بيانات سوق العمل الحقيقية بمطابقة الحديث عن أن «الذكاء العام وصل»؟[31]
ذكاء يبني ذكاءً: أول حالة واضحة يقوم فيها الذكاء الاصطناعي بمعظم العمل لبناء ذكاء أفضل منه ستعني الانتقال من الدرجة 3 نحو الدرجة 4.[32]
الخلاصة
صعدنا أول درجتين من السُّلّم:
علّمت نماذجُ اللغة الحواسيبَ كيف تستخدم اللغة.
وعلّمها الوكلاء كيف تعمل.
أما الدرجة الثالثة فهي حيث يقف عام 2026، والناس يختلفون بصدق حول ما إذا كنا قد وطئناها بعد. ويبقى الذكاء الفائق والتفرّد توقّعات ستختبر السنوات القليلة القادمة الافتراضات التي تقوم عليها. وأفضل ما يمكننا فعله جميعًا: أن نتابع الأدلّة لا العناوين، وأن نتعلّم استخدام أدوات الذكاء الاصطناعي المتاحة اليوم جيدًا.
المراجع
أُدرجت المراجع بلغتها الأصلية، وتُرجمت الاقتباسات الواردة في المقال إلى العربية. جرى الاطّلاع على جميع الروابط في 2 أكتوبر 2026. الرسوم التوضيحية أُنشئت بواسطة Google Gemini لهذا المقال، أما الأشكال والصور من مصادر أخرى فمنشورة وفق التراخيص المذكورة في تعليقاتها.
Vaswani, A., Shazeer, N., Parmar, N., Uszkoreit, J., Jones, L., Gomez, A. N., Kaiser, Ł., & Polosukhin, I. (2017). Attention Is All You Need. NeurIPS 2017. arXiv:1706.03762
Kaplan, J., McCandlish, S., Henighan, T., Brown, T. B., et al. (2020). Scaling Laws for Neural Language Models. arXiv:2001.08361
Brown, T. B., Mann, B., Ryder, N., Subbiah, M., Kaplan, J., et al. (2020). Language Models are Few-Shot Learners. NeurIPS 2020. arXiv:2005.14165
Hoffmann, J., Borgeaud, S., Mensch, A., et al. (2022). Training Compute-Optimal Large Language Models. arXiv:2203.15556
Ouyang, L., Wu, J., Jiang, X., et al. (2022). Training language models to follow instructions with human feedback. NeurIPS 2022. arXiv:2203.02155
Wei, J., Wang, X., Schuurmans, D., Bosma, M., Ichter, B., Xia, F., Chi, E., Le, Q., & Zhou, D. (2022). Chain-of-Thought Prompting Elicits Reasoning in Large Language Models. NeurIPS 2022. arXiv:2201.11903
Epoch AI. Trends in Artificial Intelligence (dashboard). epoch.ai/trends
Yao, S., Zhao, J., Yu, D., Du, N., Shafran, I., Narasimhan, K., & Cao, Y. (2023). ReAct: Synergizing Reasoning and Acting in Language Models. ICLR 2023. arXiv:2210.03629
Schick, T., Dwivedi-Yu, J., Dessì, R., Raileanu, R., Lomeli, M., Zettlemoyer, L., Cancedda, N., & Scialom, T. (2023). Toolformer: Language Models Can Teach Themselves to Use Tools. NeurIPS 2023. arXiv:2302.04761
Wang, L., Ma, C., Feng, X., Zhang, Z., et al. (2024). A Survey on Large Language Model based Autonomous Agents. Frontiers of Computer Science, 18. arXiv:2308.11432
Jimenez, C. E., Yang, J., Wettig, A., Yao, S., Pei, K., Press, O., & Narasimhan, K. (2024). SWE-bench: Can Language Models Resolve Real-World GitHub Issues? ICLR 2024. arXiv:2310.06770
Kwa, T., et al. (METR) (2025). Measuring AI Ability to Complete Long Tasks. NeurIPS 2025. arXiv:2503.14499
Anthropic (25 Nov 2024). Introducing the Model Context Protocol. anthropic.com
Surapaneni, R., Jha, M., Vakoc, M., & Segal, T. (9 Apr 2025). Announcing the Agent2Agent Protocol (A2A). Google for Developers Blog. developers.googleblog.com
Morris, M. R., Sohl-Dickstein, J., Fiedel, N., Warkentin, T., Dafoe, A., Faust, A., Farabet, C., & Legg, S. (2024). Levels of AGI for Operationalizing Progress on the Path to AGI. ICML 2024. arXiv:2311.02462
Bubeck, S., Chandrasekaran, V., Eldan, R., Gehrke, J., Horvitz, E., et al. (2023). Sparks of Artificial General Intelligence: Early experiments with GPT-4. arXiv:2303.12712
Chollet, F. (2019). On the Measure of Intelligence. arXiv:1911.01547
ARC Prize Foundation (5 Dec 2025). ARC Prize 2025 Results & Analysis. arcprize.org. See also ARC-AGI-2.
ARC Prize Foundation (2026). ARC Prize 2026: ARC-AGI-3 Competition. arcprize.org
Fox Business (3 Sep 2026). OpenAI unveils GPT-6 Astra with major advances in AI capabilities. foxbusiness.com
24/7 Wall St., via Yahoo Finance (6 Sep 2026). Jensen Huang Declares "AGI Has Arrived." finance.yahoo.com
Kamradt, G. / ARC Prize Foundation (3 Sep 2026). OpenAI's GPT-6 Astra on ARC-AGI-3. arcprize.org
NBC News (17 Mar 2025). AI that can match humans at any task will be here in five to 10 years, Google DeepMind CEO says. nbcnews.com
Snyder, G. (2 Apr 2025). Interview with Yann LeCun. Newsweek. newsweek.com
Marcus, G. (18 Oct 2025). Game over. AGI is not imminent, and LLMs are not the royal road to getting there. Marcus on AI. garymarcus.substack.com
Shojaee, P., Mirzadeh, I., Alizadeh, K., Horton, M., Bengio, S., & Farajtabar, M. (2025). The Illusion of Thinking: Understanding the Strengths and Limitations of Reasoning Models via the Lens of Problem Complexity. Apple Machine Learning Research. machinelearning.apple.com
Williams, T. (7 Sep 2026). OpenAI says the AGI era is here; experts disagree. Information Age (ACS). ia.acs.org.au
Gupta, D. (29 Sep 2026). AGI Has Not Arrived. Here Is What 2026 Actually Proved. Security Boulevard. securityboulevard.com
Kokotajlo, D., Alexander, S., Larsen, T., Lifland, E., & Dean, R. (3 Apr 2025, updated Nov 2025). AI 2027. ai-2027.com
Good, I. J. (1965). Speculations Concerning the First Ultraintelligent Machine. Advances in Computers, 6, 31–78. Academic Press. doi:10.1016/S0065-2458(08)60418-0. Quotation verified via Quote Investigator.
Bostrom, N. (2014). Superintelligence: Paths, Dangers, Strategies. Oxford University Press. ISBN 978-0199678112. Overview
Vinge, V. (1993). The Coming Technological Singularity: How to Survive in the Post-Human Era. VISION-21 Symposium, NASA Lewis Research Center. edoras.sdsu.edu
Kurzweil, R. (2005). The Singularity Is Near: When Humans Transcend Biology. Viking. ISBN 978-0-670-03384-3. Overview
Kurzweil, R. (2024). The Singularity Is Nearer: When We Merge with AI. Viking. ISBN 978-0399562761. Overview
Center for AI Safety (2023). Statement on AI Risk. safe.ai